用 Claude Code 工作有個結構性問題:session 結束,這次踩的坑、做的決策、試錯的過程全部蒸發。下次遇到同一個問題,人和 LLM 一起從零再踩一遍。
這篇介紹我照 Andrej Karpathy 的 LLM Wiki 模式建立的個人知識庫——它是什麼、解決什麼問題、以及四天實際用下來長什麼樣子。下一篇寫完整的建置與使用教學。
一、問題:知識蒸發的三種形式
Session 結束就歸零。 花兩小時跟 Claude 一起查出某個 bug 的根因,context 一清空,這段過程就只存在於沒人會回去讀的對話紀錄裡。
換專案就重踩。 在 A 專案學會怎麼用 Playwright 操作 Kendo UI 的下拉選單,到 B 專案又從頭摸一次——這種技巧明明跨專案通用,卻沒有地方累積。
三個月後的自己是陌生人。 「當初為什麼選 A 不選 B」這種決策脈絡,不寫下來就沒了;更慘的是當時猜錯的推論也沒了,於是下次還會再猜錯一次。
專案的 CLAUDE.md 能解一部分,但它有天花板:它屬於單一專案,而且它的定位是「規範」不是「知識庫」——什麼都往裡塞,就變成每個 session 都要吞一遍的雜訊。
二、Karpathy 的翻轉:從被動檢索到主動維護
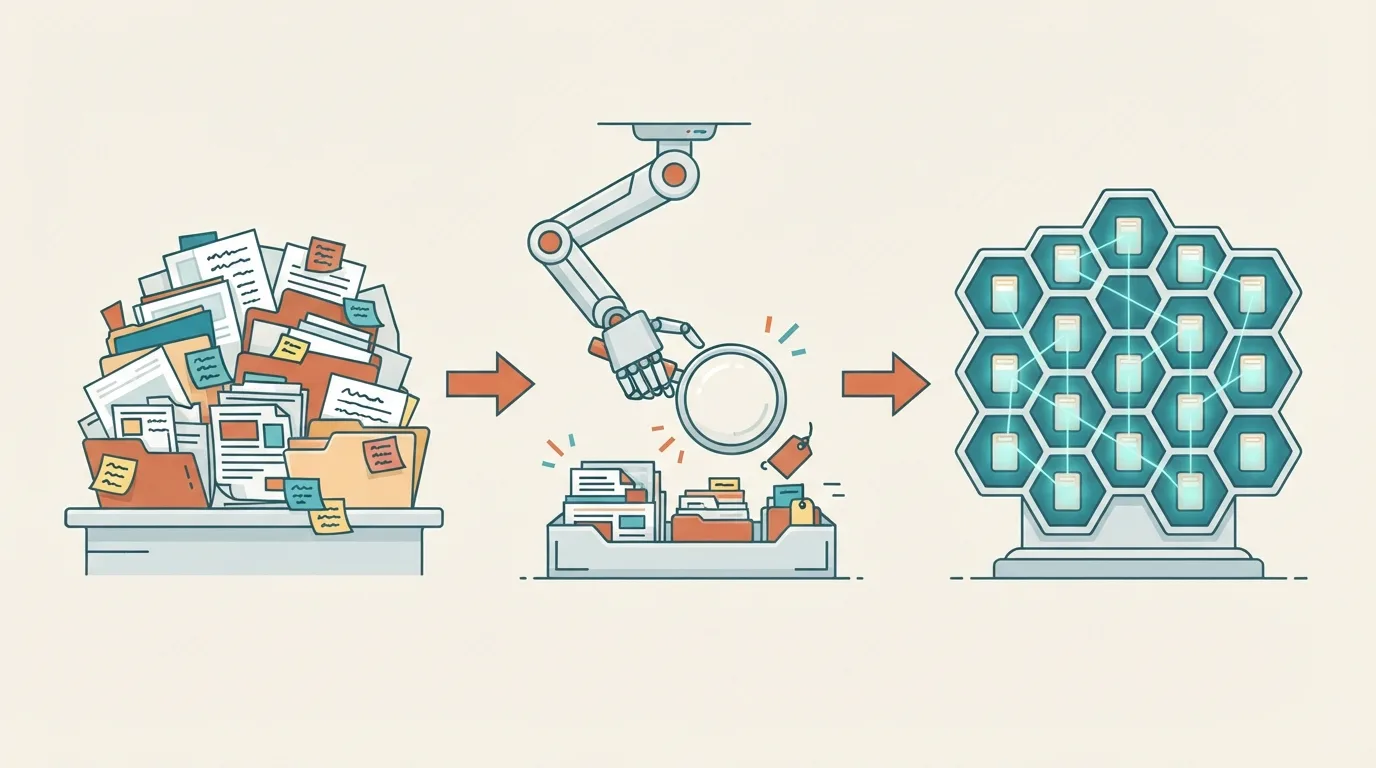
一般的 RAG(NotebookLM、ChatGPT 上傳檔案)是每次提問才臨時去原文撈片段——知識不會累積,問十次就從零拼湊十次。
LLM Wiki 反過來:每次有新東西進來,LLM 就把它整合進一個持續存在的 markdown wiki。交叉引用當下建好、矛盾當下標記、綜合結論當下更新。知識編譯一次、持續維護,而不是每次查詢重新推導。
flowchart TB
  subgraph R["一般 RAG"]
    q1([提問]) --> s1[臨時檢索原文片段] --> a1([回答])
    a1 -.->|什麼都沒留下| q1
  end
  subgraph W["LLM Wiki"]
    src([來源或實作經驗]) --> ing["LLM 整合:摘要、互連、標矛盾"]
    ing --> wiki[(持續存在的 wiki)]
    wiki --> q2([之後的每次提問])
  end
Karpathy 的 gist 給了一個很好記的比喻,我的知識庫 README 裡也抄了這句:
Obsidian 是 IDE,LLM 是工程師,wiki 是 codebase。
人不直接寫 codebase,人負責開需求、審查產出;Obsidian 只是拿來看的。
三、三層架構與分工
整個系統只有三層,權限劃得非常死:
| 層 | 位置 | 誰能寫 | 說明 |
|---|---|---|---|
| 原始來源 | raw/ |
只有我 | 文章、論文、逐字稿。LLM 只讀不改不刪——這是唯一的事實來源 |
| wiki | wiki/、index.md、log.md |
只有 LLM | 摘要頁、筆記頁、索引、日誌 |
| schema | CLAUDE.md |
共同演進 | 規範與工作流;發現不合用就提案修改 |
分工也是固定的:我負責找來源、提問、決定方向、判斷有沒有寫歪;LLM 負責讀、寫、摘要、交叉引用、標矛盾、更新索引、記日誌——所有雜活。 我原則上不手寫 wiki/ 裡的任何檔案。
「使用者不手寫 wiki」這條看起來奇怪,其實是整套系統能運作的前提:一致性只有在單一擁有者手上才維護得住。人手改一頁,格式、索引、回連就開始漂移,之後 LLM 每次寫入都要面對一個半殘的狀態。
四、雙軌設計:我對原始模式的擴充
Karpathy 的原始模式以消化外部來源為主:把論文、文章丟進 raw/,LLM 摘要成來源頁、實體頁、概念頁、綜合頁。我建庫當天就發現這對我不夠——日常在專案裡工作,最想留下的不是讀到的東西,是做過才知道的事。所以 schema 在建立當天就擴充成雙軌:
| 來源消化型 | 經驗沉澱型 | |
|---|---|---|
| 知識從哪來 | raw/ 裡的外部文件 |
實作過程 |
| 怎麼進來 | /ingest |
/distill、「寫進 wiki」 |
| 放哪 | sources/ entities/ concepts/ synthesis/ |
notes/(跨專案)projects/(單一專案) |
| 出處長怎樣 | [[S00x-…]] 引用 |
frontmatter 的 evidence: 欄位 |
經驗沉澱型收的是這四類:踩過的坑(含當時錯誤的猜測——錯誤推論本身就是知識)、為什麼選 A 不選 B、實測有效或無效的具體做法、系統的隱性行為(文件沒寫、實測才知道的)。查文件就有的 API 用法明確排除,那種東西不值得佔一頁。
誠實的數據:四天用下來,來源消化軌一次都沒用到——第一份來源 S001 至今還沒出生,九筆日誌裡七筆是沉澱。原始模式是為「讀東西」設計的,但對每天在寫程式的人,經驗沉澱才是主力。這也是為什麼我覺得這個擴充值得寫出來。
五、幾條設計得很好的鐵則
schema 裡有七條鐵則,其中幾條特別值得偷:
每個事實宣稱都要有出處。 來源消化型句末掛 [[S00x-…]],經驗沉澱型在 frontmatter 寫 evidence:(哪個專案、什麼時候、做了什麼)。無法溯源的內容只能出現在明確標示的「推論 / 待查」段落。
矛盾要留下、不要抹平。 新來源跟舊頁面衝突時,兩邊都保留、互相標註、status 改成 disputed,由人裁決。LLM 最危險的行為就是悄悄把矛盾「圓」掉。
孤兒頁是 bug。 所有頁面必須互相 [[wikilink]],沒有任何頁連進來的頁就是待修項目。
日誌 append-only。 log.md 只加不改不刪,每筆記錄做了什麼、動到哪些頁、發現什麼、下一步。知識庫自己的歷史也是知識。
這些鐵則不是裝飾。實際發生過一次:舊筆記裡有一頁把測試時驗證碼的處理方式記載反了(寫成自動辨識,實際是一律人工輸入),後來的一次沉澱抓到這個錯——更正時不是默默改掉,而是標注更正原因、保留錯誤紀錄。三個月後看到那頁,能知道它曾經錯過、為什麼錯。
六、四天用下來的樣子
| 項目 | 數值 |
|---|---|
| 建立日期 | 2026-08-06 |
| wiki 頁數 | 33(通用筆記 18、專案頁 15) |
| 涵蓋專案 | 3 個(兩個公司內部系統+這個部落格) |
| 匯入來源 | 0 份 |
| 日誌 | 9 筆(distill 7、schema 2) |
通用筆記那 18 頁大概長這樣(都是實際踩過才寫得出來的東西):Playwright 對 Kendo UI 表單的自動化技巧、ASP.NET 相對路徑隨 URL 深度解析導致的靜默 404、SQL 邏輯搬進 C# 記憶體過濾時的五個語意差異、只有二進位檔時用反編譯 diff 驗證新版改了什麼、需求文件裡「寫文件的人以為的系統」要怎麼查核。
index.md 裡每頁一行,格式固定(專案名這裡隱去):
1 | - [[ASP.NET相對路徑載入陷阱]] — `../Scripts/` 依瀏覽器 URL 深度解析, |
好處的實感主要有三個。跨 session:新 session 讀一眼 index.md 就知道庫裡有什麼,不用重新解釋。跨專案:notes/ 裡的技巧在第二個專案直接引用——有一頁的 evidence 已經標記「來自兩個專案的共同觀察」,這種頁面的可信度比單一專案的高一級。寫作素材:這個部落格〈自架瀏覽計數器〉那篇的素材,同一批也進了 wiki——部落格版是給讀者看的完整過程,wiki 版壓縮成「下次照做」的判讀步驟,兩邊分工不重複。
七、誠實的代價
沉澱不會自動發生。 要開口說「寫進 wiki」它才動。九筆日誌全是我主動觸發的——忘了說,知識照樣蒸發。這是整套系統最大的弱點:它依賴一個要人養成的習慣。
品質要抽查。 LLM 會寫歪。schema 規定寫檔前先給草稿讓我確認,但草稿擋不住所有錯——前面那個驗證碼記載錯誤,就是在寫入之後才被後來的沉澱抓到的。
Token 成本是真的。 每次沉澱都要先讀近三百行的 schema、再搜既有頁避免重複建檔,一次沉澱動輒讀寫十來個檔案。用量在意的人要有心理準備。
機密靠紀律不靠技術。 知識庫在工作機上、內容涉及公司專案。schema 明定不寫帳密、連線字串、內部主機名稱,程式碼裡的敏感值一律代換成 <佔位符>——但這是寫入紀律加上健檢兜底,不是技術保證。
規模有上限。 「讀 index.md → 跳相關頁」這種索引式導航,大約撐到 100 份來源、數百頁;超過就要加本機搜尋工具。目前 33 頁,離天花板還遠。
下一篇是實作:LLM Wiki 使用教學——怎麼建庫、怎麼讓任何專案資料夾都能一句話寫入、四個工作流各自怎麼跑、以及四天下來實際踩到的坑。
同分類的另一組文章:〈「Skills for Real Engineers」介紹〉與〈mattpocock/skills 使用教學〉——skills 管的是 agent 的做事紀律,wiki 管的是知識累積,兩套互補。


留言